🎙️ Шаг 2: Генерация Озвучки (Студия звукозаписи)
На этом этапе программа берет готовый текстовый сценарий (из Шага 1) и превращает его в профессиональную аудиодорожку.
Вам не нужно беспокоиться о том, что нейросеть прочитает технические теги или звездочки ** — софт автоматически очищает текст от любого программного мусора перед отправкой в студию.
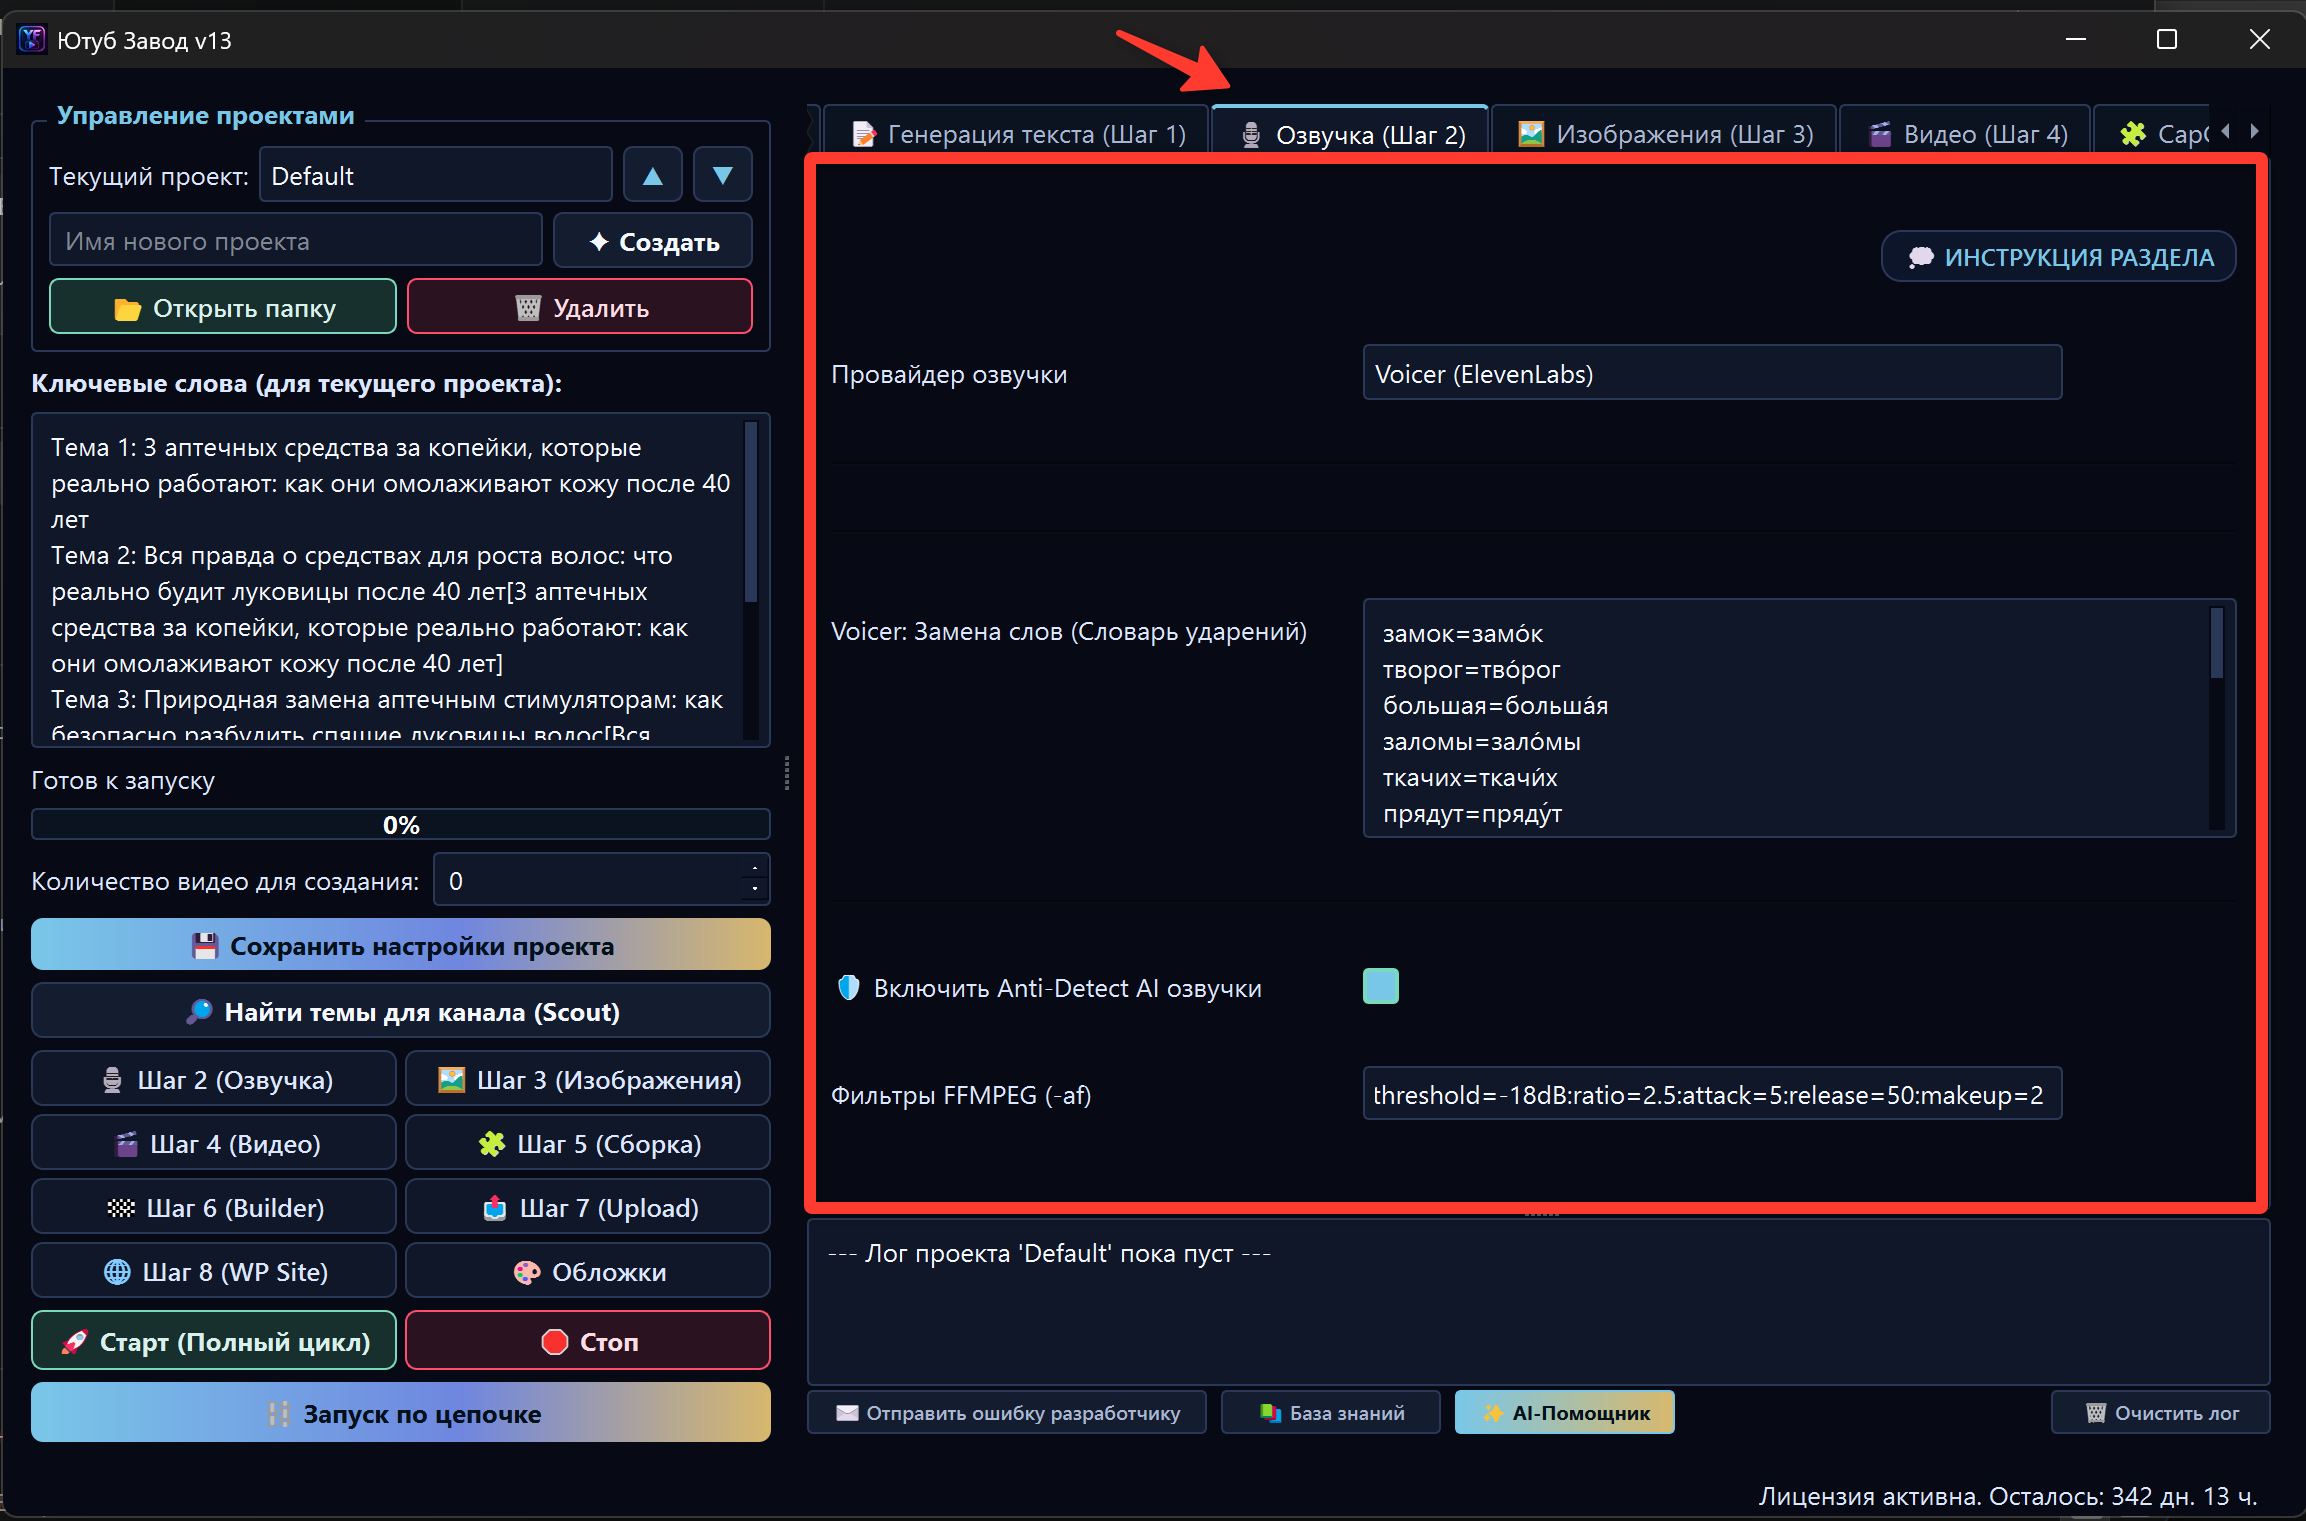
🎭 Выбор провайдера озвучки
В самом верху вкладки вы выбираете, кто будет озвучивать ваш текст. Доступны четыре варианта:
- Gemini — Бесплатный вариант от Google. Работает через ключи Google AI Studio (Free Tier). Хорошо справляется с ударениями и эмоциями, стиль голоса управляется дополнительным промтом из настроек.
- Lumean — Наша главная рекомендация для максимального реализма. Работает на базе ElevenLabs и выдает живые, эмоциональные голоса. Требует Lumean API Key и выбор шаблона голоса из списка в Базовых настройках.
- KIE ElevenLabs V3 — Прямой доступ к модели ElevenLabs
text-to-dialogue-v3через KIE.ai. Простой интерфейс: вы указываете ID голоса, язык и стабильность. Стоимость: $0.07 за 1,000 символов. - KIE ElevenLabs multilingual-v2 — Расширенная мультиязычная модель ElevenLabs через KIE.ai. Больше настроек: сходство голоса, стиль, скорость, контекст предыдущего текста. Стоимость: $0.06 за 1,000 символов.
💡 При выборе провайдера в настройках отображаются только его поля — лишние скрываются автоматически.
🛡️ Киллер-фича: Anti-Detect AI озвучки
Алгоритмы YouTube всё лучше распознают сгенерированные «идеальные» голоса. ИИ-озвучка звучит слишком чисто. Чтобы защитить ваш канал от пессимизации, мы внедрили уникальную функцию.
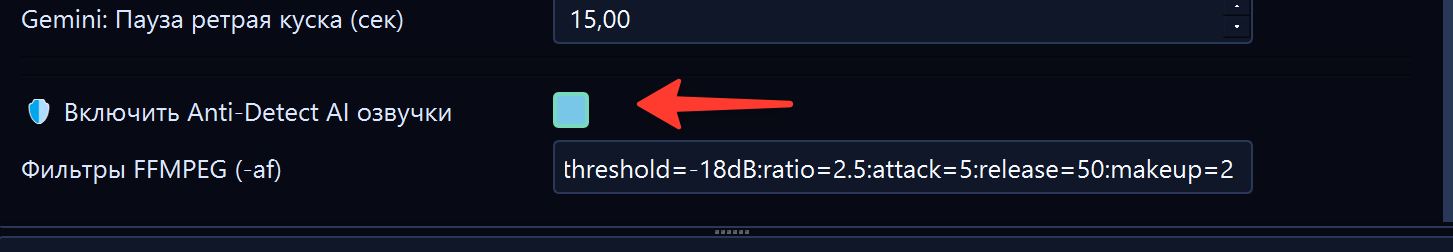
Если вы поставите галочку ✅ Включить Anti-Detect AI озвучки, программа применит к финальному аудиофайлу специальную цепь фильтров (эквалайзер, компрессор, реверберация).
Что именно делает этот фильтр:
- 🎙️ Органическое «живое» звучание: Программа деликатно обрабатывает аудиодорожку, убирая синтетическую «стерильность», присущую всем нейросетям. Голос обретает естественную теплоту, плотность и дыхание.
- 🎛️ Имитация студийной записи: Накладывается сложный, авторский комплекс аудио-фильтров. Он заставляет алгоритмы YouTube воспринимать дорожку так, словно она была записана живым диктором в профессиональной студии.
- ??️ Глубокая маскировка (Bypass AI): Устраняются скрытые цифровые паттерны и специфические аудио-маркеры, по которым боты-модераторы вычисляют сгенерированный контент. Ваш ролик получает максимальный уровень доверия алгоритмов.
💡 Совет: Мы настоятельно рекомендуем всегда держать эту галочку включенной для максимальной защиты канала.
⚙️ Настройки для Lumean (ElevenLabs)
Если вы выбрали Lumean, API-ключ и шаблон голоса настраиваются во вкладке Базовые настройки. Там же описано, как создать ключ, создать шаблон голоса в Lumean и обновить список шаблонов в программе.
На вкладке Шага 2 для Lumean доступна настройка:
- Замена слов (Словарь ударений): Иногда ИИ неправильно ставит ударения в сложных или специфических словах (например, зАмок вместо замо́к).
Впишите сюда слова, в которых нейросеть ошибается. Формат: каждое слово с новой строки через знак
=.- Пример:
замок=замо́ктворог=творо́г
- Пример:
⚙️ Настройки для KIE ElevenLabs V3
Модель text-to-dialogue-v3 — это диалоговая озвучка от ElevenLabs, доступная через KIE.ai. Отличается высокой естественностью речи и поддержкой множества языков.
Параметры:
- Voice ID — ID голоса из библиотеки ElevenLabs. Найти можно на сайте elevenlabs.io в разделе Voice Library. Нужно скопировать идентификатор нужного голоса (выглядит как
21m00Tcm4TlvDq8ikWAM). - Язык — выберите язык вашего текста (en, ru, de, fr и другие).
- Стабильность — от 0.0 до 1.0. Высокое значение (0.8–1.0) даёт монотонный, но предсказуемый голос. Низкое (0.2–0.4) — более живой и эмоциональный, но непредсказуемый. Рекомендуем 0.5 как баланс.
💡 Текст отправляется целиком одним запросом — без разбивки на куски. Это удобно для коротких текстов.
Стоимость: $0.07 за каждые 1,000 символов (автоматически считается в Аналитике расходов).
⚙️ Настройки для KIE ElevenLabs multilingual-v2
Модель text-to-speech-multilingual-v2 — это более продвинутая версия с расширенными настройками голоса. Поддерживает передачу контекста между фрагментами текста для максимальной согласованности тембра.
Параметры:
- Voice ID — ID голоса из библиотеки ElevenLabs (аналогично V3).
- Язык — выберите язык вашего текста.
- Стабильность — стабильность голоса (0.0–1.0). По умолчанию: 0.5.
- Сходство — насколько сильно голос должен быть похож на оригинал (0.0–1.0). По умолчанию: 0.75. Слишком высокое значение может создать артефакты.
- Стиль — экспрессивность и эмоциональность (0.0–1.0). 0.0 = нейтральный и стабильный. Повышайте осторожно — это увеличивает нагрузку на модель.
- Скорость — темп речи (0.7 = медленно, 1.0 = норма, 1.3 = быстро). По умолчанию: 1.0.
- Передавать контекст предыдущего текста — если включено, для каждого фрагмента программа отправляет в API последние ~150 символов предыдущего куска. Это помогает модели сохранять единый тон и тембр на стыке фрагментов (точно так же, как реализовано в Gemini TTS).
💡 При multilingual-v2 текст автоматически разбивается на чанки и обрабатывается последовательно. Это позволяет озвучивать тексты любой длины без ограничений.
Стоимость: $0.06 за каждые 1,000 символов (автоматически считается в Аналитике расходов).
⚙️ Настройки для Gemini
Если вы выбрали бесплатную озвучку от Google, вам доступны расширенные параметры режиссуры:
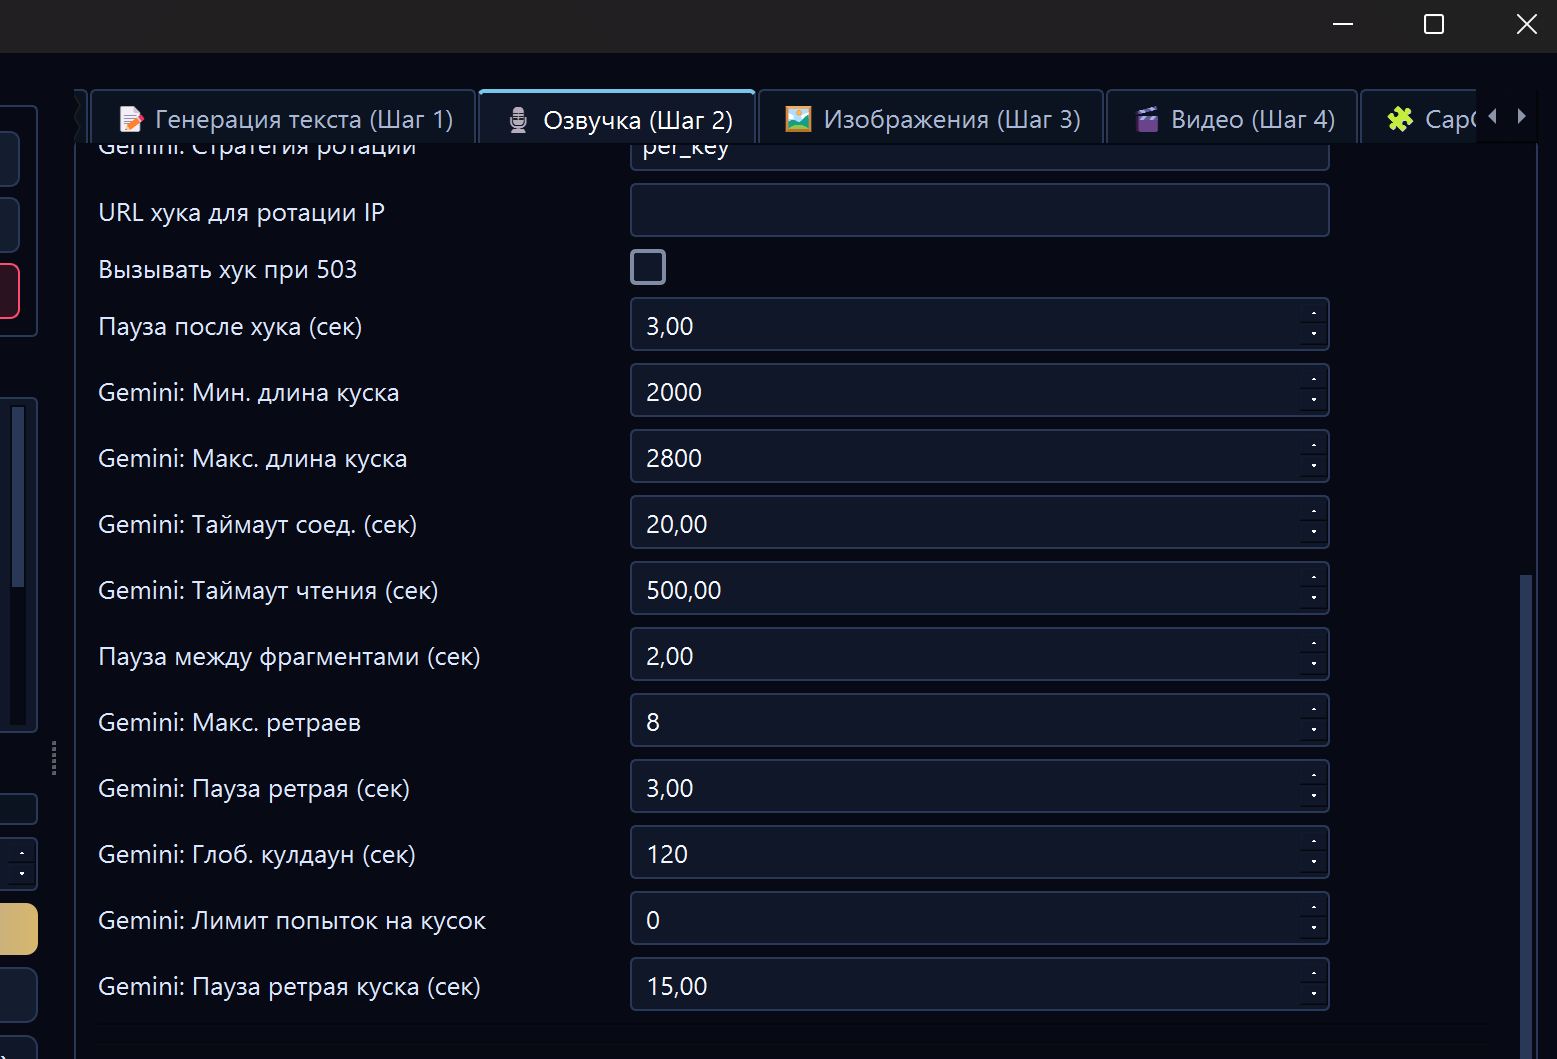
- Голос TTS: Выберите имя диктора (например, Zephyr, Puck, Vindemiatrix).
- Режиссерские указания (Director's prompt): Уникальная особенность Gemini! Вы можете словами описать, как именно нужно читать текст.
- Пример: «Ты 60-летний врач с глубоким, слегка хриплым голосом. Сцена: частная консультация в клинике. Тон: серьезный, экспертный, но очень естественный».
- Роль спикера: Как зовут вашего персонажа (например, Older Doctor).
(Технические параметры, такие как таймауты, кулдауны и лимиты чанков, уже настроены на оптимальные значения, их можно не трогать).
🎉 Итог Шага 2
Как только генерация закончится, в папке вашего проекта появится файл Final-[Номер].mp3. Это готовая, профессионально обработанная аудиодорожка.
Теперь нам нужна красивая картинка (превью) и визуальный ряд для видео. Переходим к Шагу 3: Генерация Изображений!